
7.0 学习检查表:大模型原理、Prompt 与微调
这页当成可打印检查表使用。需要完整讲解时,回到 第 7 章入口页。
两小时快速通读
Section titled “两小时快速通读”| 时间 | 做什么 | 能说出这句话就停 |
|---|---|---|
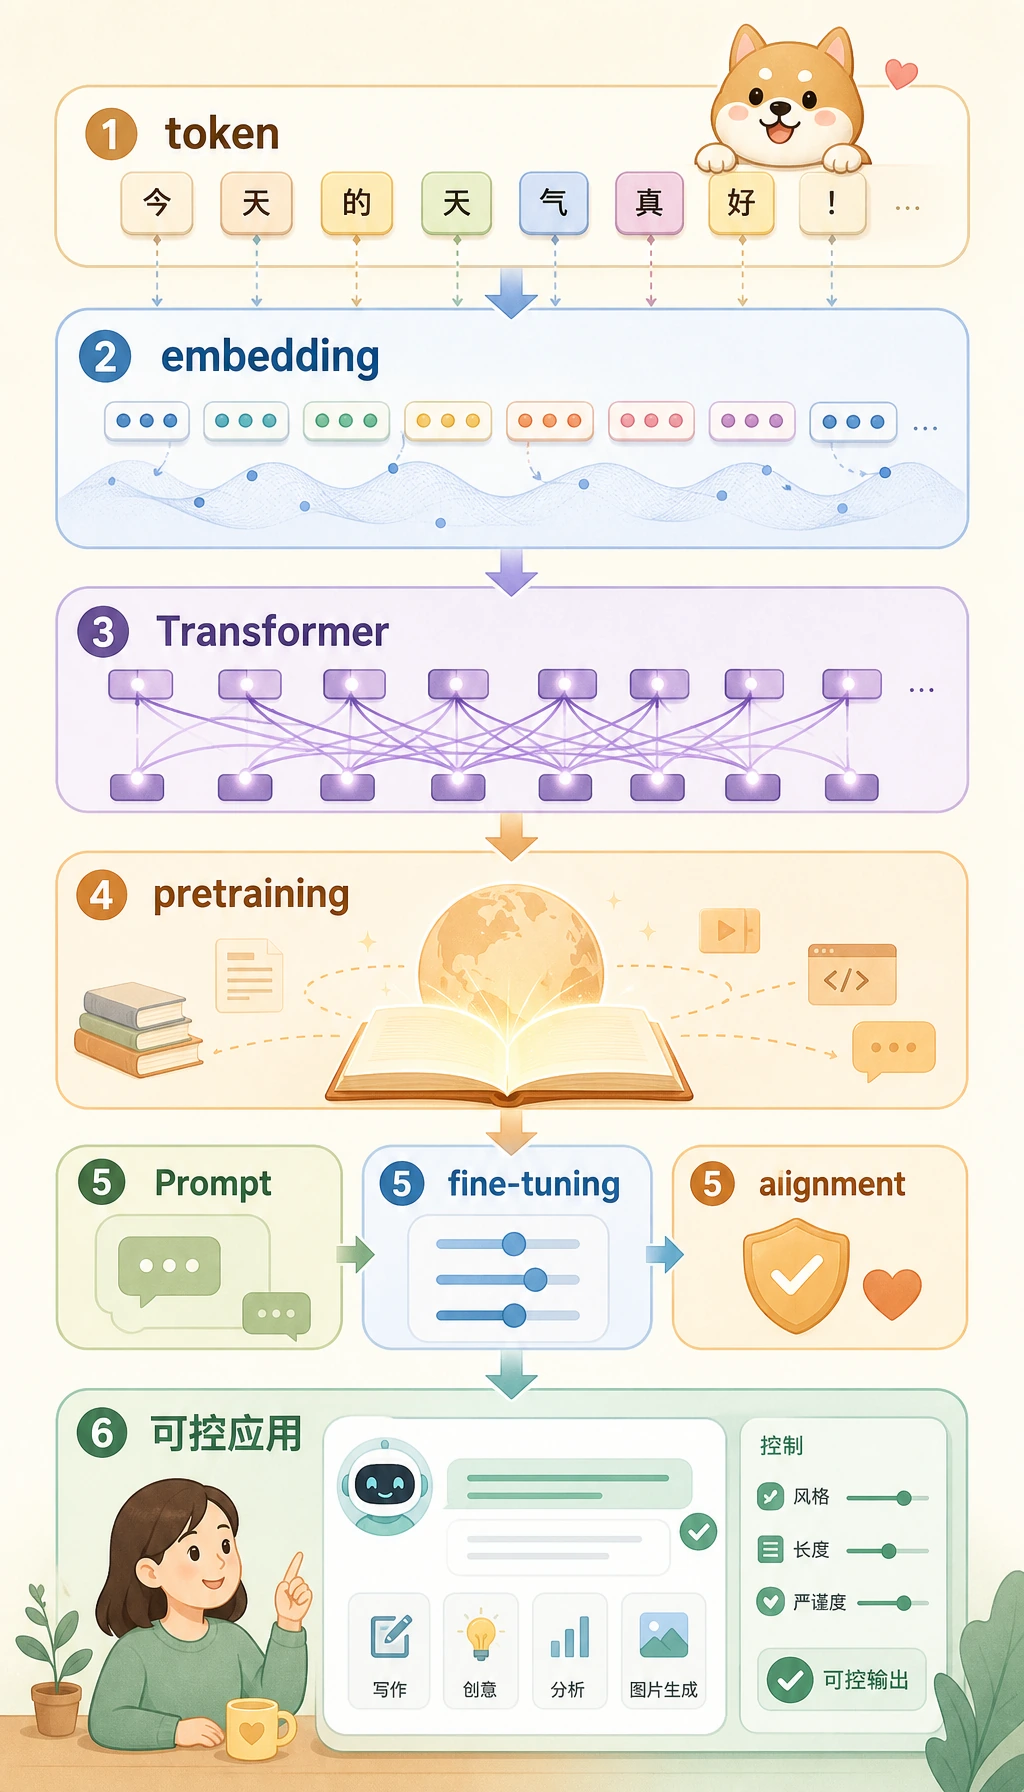
| 20 分钟 | 看入口页的“Token 到答案”图 | “文本会变成 token、向量、上下文,再进行下一个 token 预测。” |
| 25 分钟 | 浏览 7.1,并运行一个 tokenizer 示例 | “Token 数量会影响成本和上下文限制。” |
| 25 分钟 | 浏览 7.2 和大模型发展史 | “规模、数据、Transformer 和对齐改变了模型能力。” |
| 30 分钟 | 运行入口页的 Prompt 测试脚本 | “我能用固定样本比较 Prompt 版本。” |
| 20 分钟 | 阅读方案选择表 | “在检查 Prompt、RAG、工具和校验前,不该急着微调。” |
必须留下的证据
Section titled “必须留下的证据”| 证据 | 最小版本 |
|---|---|
prompts/ | 同一个任务的三个 Prompt 版本 |
prompt_eval_cases.csv | 至少五条固定输入和一个简单分数字段 |
structured_output_schema.json | 必填字段和允许的数据类型 |
failure_cases.md | 至少三个失败输出和可能原因 |
gpu_train_log.txt | 7.4.5 租 GPU 训练手搓 GPT-2 的 device: cuda 训练日志 |
llm_stage_workshop_output.txt | 7.8.4 实操:第 7 章完整工作坊 的输出 |
README.md | 如何运行、哪些通过、哪些失败、下一步怎么试 |
| 闸门 | 通过条件 |
|---|---|
| Prompt 对比 | 同一批样本、只改一个变量、保存输出和分数。 |
| 结构化输出 | 解析器会拒绝缺字段或类型错误。 |
| 失败分析 | 每个失败都有可能原因:指令、输入、结构约束、缺少知识或安全边界。 |
| 方法选择 | 决策表能解释为什么先用 Prompt、RAG、微调、工具或 Agent。 |
| 手搓 GPT-2 | 能在 CUDA GPU 上跑通 mini GPT-2,并说清 embedding、attention、loss 和 generate 在代码里的位置。 |
预期结果:你的第 7 章文件夹里有 Prompt 版本、固定评测样本、解析器/schema 检查、失败笔记、device: cuda 的 mini GPT-2 训练日志、工作坊输出,以及说明方法选择的 README。
- 你能不照抄定义,解释 token、embedding、attention、上下文窗口、预训练、Prompt、微调和对齐吗?
- 你能每次只改一个 Prompt 变量,并用同一组输入比较结果吗?
- 你能校验 JSON 输出,而不是相信“看起来像 JSON”的文本吗?
- 你能说明什么时候缺少信息应该用 RAG,而不是继续加长 Prompt 吗?
- 你能说明什么时候“长期行为适配”才可能值得微调吗?
- 你能租用或打开一台 GPU Notebook,用
device: cuda跑通 mini GPT-2,并保存 loss 下降和生成文本吗?
检查思路与讲解
- 可以把这些词放进同一条流程里理解:token 和 embedding 是表示层,attention 负责在上下文里分配关注,context window 限制一次能看到多少,pretraining 打好基础模型,Prompt 负责本次引导,微调通过数据改变行为,对齐则保证输出更有用、更安全。
- 保持同一组样本,只改一个 Prompt 变量,并同时保存输出和分数,这样比较才是可复现的,而不是凭印象。
- 用 schema 或 parser 去验证结构、必填字段和类型。只要解析失败,就直接拒绝,而不是把它当成正确结果。
- 当答案依赖文档里的新鲜、私有或可引用事实,而不是模型记忆时,就应该用 RAG。
- 只有当同一种行为在很多高质量样本里反复出现,而 Prompt 加验证还是不够时,才值得认真考虑微调。
如果答案都是可以,就进入第 8 章。第 8 章会把这些概念接到真实 LLM 应用和 RAG 系统里。
学完这一页,至少保留这张证据卡:
- 提示词版本
- 同一任务至少三个版本
- 评估用例
- 带分数和失败备注的固定输入
- 架构检查
- 结构化输出已解析并验证
- 方法选择
- Prompt/RAG/微调/工具决策已写明
- 手搓记录
- mini GPT-2 GPU 训练日志、环境信息和生成样例
- 结束证明
- 工作坊产出加 README 说明